¶ 反爬虫与反反爬虫技术详解
¶ 概述
网络爬虫(Web Crawler)与反爬虫(Anti-Crawler)技术是现代互联网数据获取与保护的核心博弈。自1990年代万维网诞生以来,这场持续三十余年的技术对抗经历了从简单规则匹配到人工智能深度博弈的完整演进。本文从技术原理、实现手段、合规规范三个维度,系统性地介绍这一领域。
爬虫技术的初衷是善意的——搜索引擎需要索引全网内容,学术研究者需要聚合公开数据,企业需要监控竞品价格。然而,随着数据成为数字经济的核心资产,恶意爬虫带来的威胁日益严峻:电商平台的商品信息被竞争对手实时监控,新闻网站的内容被批量盗用,社交平台的用户数据被非法采集。据Imperva 2024年报告显示,全球互联网流量中约49.6%来自自动化程序(Bot),其中恶意爬虫占比超过30%。
反爬虫技术正是在这一背景下不断发展。从最初简单的User-Agent过滤,到如今基于机器学习的实时行为分析,防御手段的复杂度呈指数级增长。与此同时,爬虫技术也在持续进化——从静态页面解析到浏览器自动化,从单IP单线程到分布式智能集群,双方的技术博弈从未停歇。
¶ 第一部分:反爬虫机制
¶ 1.1 反爬虫的目标与原则
核心目标:
- 保护数据资产,防止恶意批量抓取
- 保障服务器资源,避免性能过载
- 维护商业利益,防止数据被竞争对手利用
- 确保内容版权,防止未经授权的复制
设计原则:
| 原则 | 说明 | 实施要点 |
|---|---|---|
| 渐进式防御 | 从弱到强,避免误伤正常用户 | 先限流,再验证码,最后封禁 |
| 成本平衡 | 防御成本 ≤ 被爬取损失 | ROI分析驱动防护级别选择 |
| 合规合法 | 符合《网络安全法》《数据安全法》 | 保留日志,支持审计 |
| 用户体验优先 | 不影响真实用户的正常访问 | 误杀率控制在0.1%以下 |
渐进式防御的核心思想是"分级响应"。当系统检测到异常流量时,不应立即采取最严厉的措施(如永久封禁IP),而应按照预设的梯度逐步升级:
¶ 1.2 反爬虫技术分类
反爬虫技术通常按照防护层级分为三类:基础防护层、行为分析层和高级防护层。每一层对应不同的技术复杂度和防御效果。
¶ 1.2.1 基础防护层
基础防护层是反爬虫的第一道防线,实现简单、成本低,但单独使用时容易被绕过。
Robots协议
Robots协议(也称为robots.txt)是一种约定俗成的标准,用于告诉网络爬虫哪些页面可以抓取,哪些不可以。
User-agent: *
Disallow: /admin/
Disallow: /api/private/

User-agent: BadBot
Disallow: /
- 道德约束,非技术强制
- 法律上可作为诉讼依据(如hiQ Labs v. LinkedIn案)
- 应配合技术措施使用
重要提示:Robots协议本身不具备技术强制力,恶意爬虫完全可以忽略它。但在法律层面,违反Robots协议的行为可能被认定为"未经授权访问"。
User-Agent检测
User-Agent是HTTP请求头中的一个字段,用于标识客户端的类型和版本。通过检测User-Agent可以快速识别出常见的爬虫工具。
BLOCKED_UAS = [
    "curl", "wget", "python-requests", "scrapy",
    "bot", "spider", "crawler", "apache-httpclient",
    "java", "go-http-client", "node-fetch"
]

def check_ua(user_agent: str) -> bool:
    """
    检测User-Agent是否属于已知爬虫工具
    返回True表示应拦截
    """
    if not user_agent:
        return True  # 空UA视为爬虫
    ua_lower = user_agent.lower()
    return any(blocked in ua_lower for blocked in BLOCKED_UAS)

# 使用示例
ua = "python-requests/2.28.1"
if check_ua(ua):
    print(f"拦截请求: User-Agent={ua}")
IP频率限制
IP频率限制是最基础也是最有效的反爬虫手段之一。通过限制单个IP在单位时间内的请求次数,可以有效防止暴力爬取。
# Nginx限流配置
limit_req_zone $binary_remote_addr zone=crawler:10m rate=10r/m;

server {
    location / {
        limit_req zone=crawler burst=5 nodelay;
        proxy_pass http://backend;
    }
}
上述配置的含义是:
zone=crawler:10m:创建一个名为"crawler"的共享内存区,大小为10MBrate=10r/m:每个IP每分钟最多10个请求burst=5:允许突发5个请求nodelay:不延迟处理突发请求
限流算法对比:
| 算法 | 原理 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| 固定窗口 | 按时间窗口计数 | 实现简单 | 窗口边界突发 | 简单限流 |
| 滑动窗口 | 精确计算时间窗口 | 平滑限流 | 内存开销大 | 精确限流 |
| 令牌桶 | 以固定速率产生令牌 | 允许突发 | 实现复杂 | API限流 |
| 漏桶 | 以固定速率处理请求 | 绝对平滑 | 无突发能力 | 流量整形 |
令牌桶算法Python实现:
import time
from threading import Lock

class TokenBucket:
    """令牌桶限流器"""
    def __init__(self, rate: float, capacity: int):
        """
        rate: 每秒产生令牌数
        capacity: 桶容量(最大突发请求数)
        """
        self.rate = rate
        self.capacity = capacity
        self.tokens = capacity
        self.last_update = time.time()
        self.lock = Lock()

    def allow_request(self, tokens: int = 1) -> bool:
        with self.lock:
            now = time.time()
            elapsed = now - self.last_update
            # 补充令牌
            self.tokens = min(
                self.capacity,
                self.tokens + elapsed * self.rate
            )
            self.last_update = now
            # 消费令牌
            if self.tokens >= tokens:
                self.tokens -= tokens
                return True
            return False

# 使用:每秒产生2个令牌,桶容量10
bucket = TokenBucket(rate=2, capacity=10)
for i in range(15):
    if bucket.allow_request():
        print(f"请求{i+1}: 通过")
    else:
        print(f"请求{i+1}: 被限流")
    time.sleep(0.3)
¶ 1.2.2 行为分析层
当基础防护被绕过时,行为分析层通过检测访问模式来识别爬虫。
请求频率模式检测
正常用户与爬虫在行为模式上存在显著差异:
| 正常用户行为 | 爬虫行为特征 | 检测指标 |
|---|---|---|
| 访问间隔不规则(均值3-8秒,标准差>2秒) | 固定时间间隔(如精确1秒) | 间隔方差系数 |
| 页面停留时间差异大(5-120秒) | 停留时间极短且固定(<1秒) | 停留时间分布 |
| 点击路径符合逻辑(首页→分类→详情) | 直接访问深层链接 | 访问深度分布 |
| 滚动、鼠标移动、点击等交互 | 无交互或模拟交互 | 交互事件密度 |
行为特征量化分析:
假设某网站记录了以下用户访问数据(单位:秒):
正常用户A: [3.2, 5.1, 2.8, 7.3, 4.5, 6.2]  均值=4.85, 标准差=1.72
正常用户B: [2.1, 8.5, 3.3, 9.2, 4.1]        均值=5.44, 标准差=3.08
爬虫C:      [1.0, 1.0, 1.0, 1.0, 1.0]        均值=1.00, 标准差=0.00
通过计算变异系数(),可以清晰区分正常用户和爬虫:
- 正常用户A:
- 正常用户B:
- 爬虫C:
当时,可高度怀疑为自动化程序。
JavaScript挑战
JavaScript挑战是一种"证明你是浏览器"的验证方式。服务器发送一段JavaScript代码,要求客户端执行并返回结果。
(function() {
    var timestamp = Date.now();
    var token = btoa(timestamp + "secret_salt");
    document.cookie = "js_challenge=" + token + "; path=/";
    // 真实场景中,secret_salt应定期轮换
})();
这种挑战的有效性基于一个前提:真正的浏览器能够执行JavaScript,而简单的HTTP客户端(如curl、requests)不能。但现代爬虫框架(如Playwright、Puppeteer)已经能够完美执行JavaScript,因此这种挑战需要与其他手段结合使用。
Canvas指纹检测
Canvas指纹利用HTML5 Canvas API在不同设备、浏览器上渲染相同内容时产生的微小差异来识别设备。
function getCanvasFingerprint() {
    const canvas = document.createElement('canvas');
    const ctx = canvas.getContext('2d');
    ctx.textBaseline = 'top';
    ctx.font = '14px Arial';
    ctx.fillText('Hello, World! 你好,世界!', 2, 2);
    ctx.fillStyle = '#f60';
    ctx.fillRect(125, 1, 62, 20);
    return canvas.toDataURL();
}

// 不同浏览器/显卡组合会产生不同的哈希值
// Chrome 120 + NVIDIA RTX 4090: "data:image/png;base64,iVBORw0KGgo..."
// Safari 17 + Apple M3: "data:image/png;base64,iVBORw0KGgo..."
Canvas指纹的独特性非常高。根据AmIUnique.org的研究,Canvas指纹的熵值约为5.7 bits,意味着大约可以区分种不同的设备配置。
¶ 1.2.3 高级防护层
验证码系统(CAPTCHA)
验证码(Completely Automated Public Turing test to tell Computers and Humans Apart)是最经典的人机验证手段。
| 类型 | 原理 | 代表产品 | 用户体验 | 安全性 | 成本 |
|---|---|---|---|---|---|
| 图片验证码 | 扭曲文字识别 | 传统方案 | ⭐⭐ 差 | ⭐⭐ 低 | 低 |
| 滑动验证 | 轨迹分析 | 极验、腾讯防水墙 | ⭐⭐⭐ 中 | ⭐⭐⭐ 中 | 中 |
| 点选验证 | 图像识别+点击 | 阿里云验证码 | ⭐⭐⭐ 中 | ⭐⭐⭐⭐ 高 | 中 |
| 无感验证 | 行为分析 | Google reCAPTCHA v3 | ⭐⭐⭐⭐⭐ 优 | ⭐⭐⭐⭐ 高 | 高 |
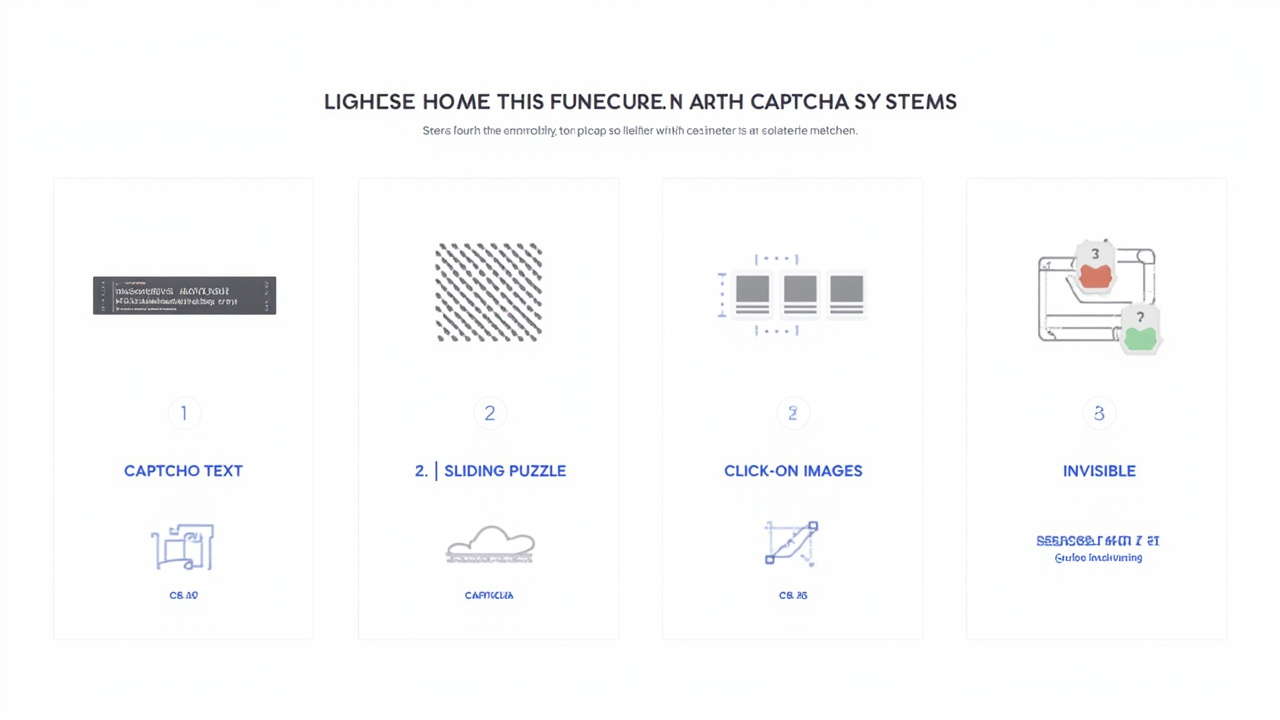
reCAPTCHA v3 评分机制:
Google reCAPTCHA v3采用0-1分的评分系统,无需用户交互:
- 1.0:极可能是人类
- 0.7-0.9:可能是人类,建议放行
- 0.3-0.6:可疑,建议二次验证
- 0.0-0.2:极可能是机器人,建议拦截
// reCAPTCHA v3 集成示例
grecaptcha.ready(function() {
    grecaptcha.execute('your_site_key', {action: 'submit'})
    .then(function(token) {
        // 将token发送到后端验证
        fetch('/api/verify', {
            method: 'POST',
            body: JSON.stringify({token: token})
        });
    });
});
设备指纹识别
设备指纹(Device Fingerprinting)通过收集浏览器和设备的多种特征,生成一个唯一标识符。
DEVICE_FP_DIMENSIONS = {
    "screen": ["width", "height", "colorDepth", "pixelRatio"],
    "navigator": ["userAgent", "language", "platform", "hardwareConcurrency"],
    "webgl": ["vendor", "renderer", "unmaskedVendor", "unmaskedRenderer"],
    "fonts": ["installed_fonts_list"],  # 通常检测50-100种字体
    "timezone": "Intl.DateTimeFormat().resolvedOptions().timeZone",
    "canvas": "canvas.toDataURL()",
    "audio": "AudioContext.sampleRate",
    "plugins": "navigator.plugins",
    "storage": ["localStorage", "sessionStorage", "indexedDB"]
}
设备指纹的识别精度非常高。FingerprintJS(现更名为Fingerprint Pro)声称其访客识别准确率达到99.5%,即使浏览器隐私模式、VPN、清除Cookie等操作也无法完全规避。
TLS指纹检测
TLS指纹(JA3/JA3S)是一种基于TLS握手过程中客户端发送的密码套件、扩展列表等特征生成的哈希值。
| 客户端 | JA3指纹示例 | 特征说明 |
|---|---|---|
| Chrome 120 | 769,47-53-5-10-... |
支持TLS 1.3,特定扩展顺序 |
| Firefox 121 | 769,4865-4867-... |
不同的密码套件优先级 |
| Python requests | 769,49195-49199-... |
仅支持TLS 1.2,扩展较少 |
| curl | 769,49199-49195-... |
与浏览器明显不同 |
# 使用ja3库检测TLS指纹
import ja3

def analyze_tls_fingerprint(pcap_file):
    """分析PCAP文件中的TLS指纹"""
    records = ja3.process_pcap(pcap_file)
    for record in records:
        ja3_hash = record.get('ja3')
        source_ip = record.get('source_ip')
        # 与已知指纹库比对
        if ja3_hash in KNOWN_BOT_FINGERPRINTS:
            print(f"检测到爬虫: {source_ip}, JA3={ja3_hash}")
动态渲染(SSR/CSR混合)
动态渲染根据请求来源决定返回完整HTML还是简化版本。
def render_page(request):
    """
    根据请求特征决定渲染策略
    """
    if is_suspicious(request):
        # 对可疑请求返回简化页面(无关键数据)
        return render_minimal()
    elif is_bot(request):
        # 对搜索引擎爬虫返回SSR页面
        return render_ssr()
    else:
        # 对正常用户返回CSR页面
        return render_full()

def is_suspicious(request):
    """检测可疑请求"""
    checks = [
        request.headers.get('User-Agent') in BLOCKED_UAS,
        request.rate_limit_exceeded,
        request.fingerprint_score < 0.3,
        request.ja3_hash in SUSPICIOUS_JA3
    ]
    return any(checks)
¶ 1.3 业界最新技术(2024-2025)
AI驱动的行为分析
传统的规则引擎难以应对日益复杂的爬虫行为。2024年以来,基于深度学习的行为分析系统成为大型平台的标准配置。
模型架构示例:
import torch
import torch.nn as nn

class BehaviorAnalyzer(nn.Module):
    """
    基于Transformer的用户行为分析模型
    输入:用户行为序列(点击、滚动、停留时间等)
    输出:人类概率(0-1)
    """
    def __init__(self, input_dim=64, hidden_dim=256, num_layers=4):
        super().__init__()
        self.embedding = nn.Linear(input_dim, hidden_dim)
        self.transformer = nn.TransformerEncoder(
            nn.TransformerEncoderLayer(
                d_model=hidden_dim,
                nhead=8,
                dim_feedforward=hidden_dim*4,
                batch_first=True
            ),
            num_layers=num_layers
        )
        self.classifier = nn.Sequential(
            nn.Linear(hidden_dim, 64),
            nn.ReLU(),
            nn.Dropout(0.3),
            nn.Linear(64, 1),
            nn.Sigmoid()
        )

    def forward(self, x):
        # x: (batch, seq_len, input_dim)
        x = self.embedding(x)
        x = self.transformer(x)
        # 取序列最后一个时间步
        x = x[:, -1, :]
        return self.classifier(x)
WebAssembly反调试
WebAssembly(WASM)允许将关键逻辑编译为二进制格式,增加逆向工程难度。
use wasm_bindgen::prelude::*;

#[wasm_bindgen]
pub fn calculate_token(input: &str) -> String {
    // 关键逻辑隐藏在WASM中
    // 即使爬虫能执行JS,也难以逆向WASM
    let mut result = String::new();
    for (i, c) in input.chars().enumerate() {
        result.push((c as u8 ^ (i as u8 + 42)) as char);
    }
    base64::encode(result)
}
边缘计算防护(Cloudflare/AWS WAF)
现代CDN提供商集成了强大的Bot管理功能:
| 服务商 | 产品名称 | 核心能力 | 定价模式 |
|---|---|---|---|
| Cloudflare | Bot Management | 机器学习分类、JS挑战、CAPTCHA | $20/月/域名起 |
| AWS | WAF Bot Control | 托管规则、速率限制、IP信誉 | $10/月/规则 + 请求量 |
| Akamai | Bot Manager | 行为分析、指纹识别、自适应挑战 | 企业定价 |
| DataDome | Real-time Bot Protection | AI检测、无感验证、API保护 | $299/月起 |
¶ 第二部分:反反爬虫技术
¶ 2.1 基础对抗手段
User-Agent伪装
User-Agent伪装是最基础的反反爬虫手段,通过模拟真实浏览器的User-Agent来规避简单的UA检测。
import random

USER_AGENTS = [
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:121.0) Gecko/20100101 Firefox/121.0",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/605.1.15 (KHTML, like Gecko) Version/17.2 Safari/605.1.15"
]

HEADERS = {
    "User-Agent": random.choice(USER_AGENTS),
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
    "Accept-Encoding": "gzip, deflate, br",
    "Referer": "https://www.google.com/",
    "DNT": "1",
    "Connection": "keep-alive",
    "Upgrade-Insecure-Requests": "1",
    "Sec-Fetch-Dest": "document",
    "Sec-Fetch-Mode": "navigate",
    "Sec-Fetch-Site": "cross-site",
    "Sec-Fetch-User": "?1",
    "Cache-Control": "max-age=0"
}

response = requests.get(url, headers=HEADERS)
IP代理池
当单一IP被限流或封禁时,使用代理IP池轮换请求来源是最常见的解决方案。
| 代理类型 | 匿名性 | 成本($/IP/月) | 稳定性 | 典型延迟 | 适用场景 |
|---|---|---|---|---|---|
| 数据中心代理 | 低(易被识别) | $0.5-2 | 中 | 50-200ms | 低频率、非敏感站点 |
| 住宅代理 | 高(真实用户IP) | $5-15 | 高 | 100-500ms | 高匿名需求 |
| 移动代理 | 高(蜂窝网络IP) | $10-30 | 高 | 200-800ms | 移动端模拟 |
| 轮换代理 | 高(每次请求不同IP) | $3-10 | 中 | 100-300ms | 大规模采集 |
代理池管理示例:
import requests
from urllib.parse import urlparse

class ProxyPool:
    """代理IP池管理器"""
    def __init__(self, proxy_api_url):
        self.proxy_api = proxy_api_url
        self.proxies = []
        self.failed_proxies = set()
        self._refresh_proxies()

    def _refresh_proxies(self):
        """从API获取新代理"""
        try:
            resp = requests.get(self.proxy_api, timeout=10)
            self.proxies = resp.json().get('proxies', [])
        except Exception as e:
            print(f"获取代理失败: {e}")

    def get_proxy(self):
        """获取一个可用代理"""
        available = [p for p in self.proxies
                     if p['host'] not in self.failed_proxies]
        if not available:
            self._refresh_proxies()
            available = self.proxies
        return random.choice(available) if available else None

    def mark_failed(self, proxy):
        """标记代理为失效"""
        self.failed_proxies.add(proxy['host'])

# 使用示例
pool = ProxyPool("https://proxy-provider.com/api/get")
proxy = pool.get_proxy()
proxies = {
    "http": f"http://{proxy['host']}:{proxy['port']}",
    "https": f"http://{proxy['host']}:{proxy['port']}"
}
response = requests.get(url, proxies=proxies, timeout=30)
请求频率控制
模拟人类的不规则访问间隔是规避频率检测的关键。
import time
import random
import numpy as np

def human_like_delay(min_sec=2, max_sec=8, distribution='lognormal'):
    """
    生成人类-like的随机延迟
    distribution: 'uniform', 'normal', 'lognormal', 'exponential'
    """
    if distribution == 'uniform':
        delay = random.uniform(min_sec, max_sec)
    elif distribution == 'normal':
        # 正态分布,均值在中间
        mu = (min_sec + max_sec) / 2
        sigma = (max_sec - min_sec) / 4
        delay = random.gauss(mu, sigma)
        delay = max(min_sec, min(max_sec, delay))
    elif distribution == 'lognormal':
        # 对数正态分布:大多数请求间隔较短,偶尔较长
        mu = 1.5
        sigma = 0.5
        delay = random.lognormvariate(mu, sigma)
        delay = min_sec + (delay / 10) * (max_sec - min_sec)
        delay = min(max_sec, delay)
    elif distribution == 'exponential':
        # 指数分布
        lam = 1 / ((min_sec + max_sec) / 2)
        delay = random.expovariate(lam)
        delay = min_sec + delay
        delay = min(max_sec, delay)

    return delay

# 模拟人类浏览模式
for url in url_list:
    fetch(url)
    delay = human_like_delay(distribution='lognormal')
    print(f"等待 {delay:.2f} 秒...")
    time.sleep(delay)
不同延迟分布的统计特性对比:
| 分布类型 | 均值(秒) | 标准差 | CV | 模拟效果 |
|---|---|---|---|---|
| 固定间隔 | 5.0 | 0.0 | 0.00 | ❌ 极易被检测 |
| 均匀分布 | 5.0 | 1.73 | 0.35 | ⚠️ 仍显规律 |
| 正态分布 | 5.0 | 1.50 | 0.30 | ⚠️ 对称性不自然 |
| 对数正态 | 4.2 | 2.10 | 0.50 | ✅ 最接近人类 |
| 指数分布 | 5.0 | 5.0 | 1.00 | ✅ 长尾特性自然 |
¶ 2.2 中级对抗技术
Cookie和Session管理
现代网站大量使用Cookie和Session来跟踪用户状态。爬虫需要正确管理这些状态才能持续访问。
import requests

session = requests.Session()

# 第一步:访问首页获取初始Cookie
session.get("https://example.com/")
# 此时session自动保存了服务器设置的Cookie

# 第二步:访问数据页面(携带Cookie)
response = session.get("https://example.com/data")
# 服务器识别为同一用户会话

# 高级:自定义Cookie策略
session.cookies.set('custom_token', 'value', domain='example.com')
JavaScript执行环境
当目标网站使用JavaScript动态渲染内容时,需要使用真实的浏览器环境。
from playwright.sync_api import sync_playwright

def fetch_with_browser(url):
    """使用真实浏览器获取动态渲染内容"""
    with sync_playwright() as p:
        # 启动浏览器(headless模式)
        browser = p.chromium.launch(headless=True)
        context = browser.new_context(
            viewport={'width': 1920, 'height': 1080},
            user_agent='Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36'
        )
        page = context.new_page()

        # 拦截请求,模拟真实网络条件
        page.route("**/*", lambda route: route.continue_())

        # 访问页面
        page.goto(url, wait_until='networkidle')

        # 等待动态内容加载
        page.wait_for_selector(".data-loaded", timeout=10000)

        # 模拟人类行为:滚动页面
        page.evaluate("""
            async () => {
                await new Promise(resolve => {
                    let totalHeight = 0;
                    const distance = 100;
                    const timer = setInterval(() => {
                        window.scrollBy(0, distance);
                        totalHeight += distance;
                        if (totalHeight >= document.body.scrollHeight) {
                            clearInterval(timer);
                            resolve();
                        }
                    }, 100);
                });
            }
        """)

        content = page.content()
        browser.close()
        return content
验证码识别
验证码是反爬虫的最后一道防线,也是爬虫面临的最大挑战。
| 方案 | 原理 | 准确率 | 成本 | 合规性 | 延迟 |
|---|---|---|---|---|---|
| 第三方打码平台 | 人工识别 | 95-99% | $0.001-0.01/次 | ⚠️ 灰色地带 | 5-30秒 |
| OCR(Tesseract) | 传统图像识别 | 60-80% | 免费 | ✅ 合规 | <1秒 |
| 机器学习模型 | CNN/RNN | 85-95% | 高(训练成本) | ✅ 合规 | <1秒 |
| AI大模型(GPT-4V) | 多模态理解 | 90-95% | $0.01-0.05/次 | ✅ 合规 | 2-5秒 |
| 专用验证码识别服务 | 预训练模型 | 90-98% | $0.002-0.01/次 | ⚠️ 视用途 | <2秒 |
# 使用AI大模型识别验证码示例
import base64
import openai

def solve_captcha_with_ai(image_path):
    """使用GPT-4V识别验证码"""
    with open(image_path, "rb") as f:
        image_base64 = base64.b64encode(f.read()).decode()

    response = openai.ChatCompletion.create(
        model="gpt-4-vision-preview",
        messages=[{
            "role": "user",
            "content": [
                {"type": "text", "text": "请识别图片中的验证码文字,只返回文字内容,不要其他解释。"},
                {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{image_base64}"}}
            ]
        }],
        max_tokens=50
    )
    return response.choices[0].message.content.strip()
¶ 2.3 高级对抗技术
浏览器指纹伪装
现代反爬虫系统大量使用浏览器指纹技术。要绕过这种检测,需要全面伪装浏览器环境。
from playwright.sync_api import sync_playwright

def create_stealth_browser():
    """创建具有反检测能力的浏览器实例"""
    with sync_playwright() as p:
        # 使用puppeteer-extra-plugin-stealth的Playwright等价方案
        browser = p.chromium.launch(
            headless=True,
            args=[
                '--disable-blink-features=AutomationControlled',
                '--disable-web-security',
                '--disable-features=IsolateOrigins,site-per-process',
            ]
        )

        context = browser.new_context(
            viewport={'width': 1920, 'height': 1080},
            user_agent='Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36',
            locale='zh-CN',
            timezone_id='Asia/Shanghai',
            permissions=['notifications'],
            color_scheme='light',
            # 伪装WebGL
            extra_http_headers={
                'Accept-Language': 'zh-CN,zh;q=0.9,en;q=0.8',
            }
        )

        # 注入反检测脚本
        context.add_init_script("""
            // 删除navigator.webdriver属性
            Object.defineProperty(navigator, 'webdriver', {
                get: () => undefined
            });

            // 伪装Chrome运行时
            window.chrome = {
                runtime: {},
                loadTimes: function() {},
                csi: function() {},
                app: {}
            };

            // 伪装WebGL
            const getParameter = WebGLRenderingContext.prototype.getParameter;
            WebGLRenderingContext.prototype.getParameter = function(parameter) {
                if (parameter === 37445) return 'Intel Inc.';
                if (parameter === 37446) return 'Intel Iris OpenGL Engine';
                return getParameter(parameter);
            };

            // 伪装插件
            Object.defineProperty(navigator, 'plugins', {
                get: () => [
                    {name: 'Chrome PDF Plugin'},
                    {name: 'Native Client'},
                    {name: 'Widevine Content Decryption Module'}
                ]
            });
        """)

        return browser, context
TLS指纹伪装
TLS指纹是近年来反爬虫系统广泛采用的检测手段。要绕过这种检测,需要使用与目标浏览器完全相同的TLS握手参数。
import subprocess

def fetch_with_chrome_tls(url):
    """
    使用curl-impersonate库模拟Chrome的TLS指纹
    curl-impersonate是libcurl的修改版本,能够模拟主流浏览器的TLS指纹
    """
    result = subprocess.run([
        "curl_chrome120",  # 模拟Chrome 120的TLS指纹
        "-s", "-L",
        "-H", "User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
        "-H", "Accept: text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
        "-H", "Accept-Language: zh-CN,zh;q=0.9",
        "--compressed",
        url
    ], capture_output=True, text=True)
    return result.stdout

# 安装curl-impersonate
# Docker: docker run --rm lwthiker/curl-impersonate:0.6-chrome curl_chrome120 https://example.com
分布式爬虫架构
对于大规模数据采集任务,单机爬虫远远不够。分布式架构可以实现横向扩展。
Scrapy分布式架构示例:
# settings.py - Scrapy分布式配置
BOT_NAME = 'distributed_crawler'

# 使用Scrapy-Redis实现分布式
SCHEDULER = "scrapy_redis.scheduler.Scheduler"
DUPEFILTER_CLASS = "scrapy_redis.dupefilter.RFPDupeFilter"
REDIS_URL = 'redis://redis-master:6379'

# 下载中间件:自动轮换代理
DOWNLOADER_MIDDLEWARES = {
    'crawler.middlewares.ProxyMiddleware': 350,
    'crawler.middlewares.RetryMiddleware': 550,
    'scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware': 400,
}

# 并发控制
CONCURRENT_REQUESTS = 16
DOWNLOAD_DELAY = 2
RANDOMIZE_DOWNLOAD_DELAY = 1.5

# proxy_middleware.py
import requests

class ProxyMiddleware:
    def __init__(self):
        self.proxy_api = "http://proxy-pool:8080/get"

    def process_request(self, request, spider):
        proxy = requests.get(self.proxy_api).json()
        request.meta['proxy'] = f"http://{proxy['ip']}:{proxy['port']}"
¶ 2.4 2024-2025最新技术
AI驱动的智能爬虫
大型语言模型(LLM)的出现彻底改变了爬虫技术。传统爬虫需要针对每个网站编写特定的解析规则,而AI驱动的爬虫可以理解页面结构,自动适配网站改版。
from openai import OpenAI
import json

class AICrawler:
    """基于LLM的智能爬虫"""
    def __init__(self):
        self.client = OpenAI()

    def extract_data(self, html_content, instruction):
        """
        使用LLM从HTML中提取结构化数据
        """
        prompt = f"""
        从以下HTML内容中提取数据。
        提取要求:{instruction}

        HTML内容:
        {html_content[:8000]}  # 截断以控制token数

        请返回JSON格式的结果。
        """

        response = self.client.chat.completions.create(
            model="gpt-4o",
            messages=[{"role": "user", "content": prompt}],
            response_format={"type": "json_object"}
        )

        return json.loads(response.choices[0].message.content)

# 使用示例
crawler = AICrawler()
result = crawler.extract_data(
    html_content=page_html,
    instruction="提取所有商品名称、价格和评分"
)
print(result)
# 输出: {"products": [{"name": "...", "price": "...", "rating": "..."}]}
Puppeteer-Extra插件生态
puppeteer-extra是一个增强版的Puppeteer,提供了丰富的反检测插件。
const puppeteer = require('puppeteer-extra');
const StealthPlugin = require('puppeteer-extra-plugin-stealth');
const AdblockerPlugin = require('puppeteer-extra-plugin-adblocker');

// 启用隐身模式
puppeteer.use(StealthPlugin());
puppeteer.use(AdblockerPlugin({ blockTrackers: true }));

(async () => {
    const browser = await puppeteer.launch({
        headless: true,
        args: ['--no-sandbox', '--disable-setuid-sandbox']
    });

    const page = await browser.newPage();

    // 测试反检测效果
    await page.goto('https://bot.sannysoft.com');
    await page.screenshot({ path: 'stealth-test.png' });

    await browser.close();
})();
移动端仿真
随着移动互联网的发展,越来越多的网站对移动端和PC端返回不同的内容。移动端仿真成为爬虫的必备能力。
from playwright.sync_api import sync_playwright

def mobile_crawl(url):
    """模拟iPhone访问移动端页面"""
    with sync_playwright() as p:
        browser = p.chromium.launch()

        # iPhone 14 Pro 设备参数
        mobile_emulation = {
            "deviceMetrics": {
                "width": 393,
                "height": 852,
                "pixelRatio": 3
            },
            "userAgent": (
                "Mozilla/5.0 (iPhone; CPU iPhone OS 17_0 like Mac OS X) "
                "AppleWebKit/605.1.15 (KHTML, like Gecko) "
                "Version/17.0 Mobile/15E148 Safari/604.1"
            ),
            "viewport": {
                "width": 393,
                "height": 852
            },
            "touch": True,
            "hasTouch": True,
            "isMobile": True
        }

        context = browser.new_context(**mobile_emulation)
        page = context.new_page()

        # 模拟触摸事件
        page.evaluate("""
            window.ontouchstart = function() {};
            document.documentElement.style.touchAction = 'manipulation';
        """)

        page.goto(url)
        content = page.content()
        browser.close()
        return content
¶ 第三部分:合规与规范
¶ 3.1 中国法律法规
爬虫技术的使用必须严格遵守相关法律法规。以下是中国与爬虫相关的主要法律框架:
《网络安全法》(2017年6月1日施行)
- 第二十七条:任何个人和组织不得从事非法侵入他人网络、干扰他人网络正常功能、窃取网络数据等危害网络安全的活动。
- 第四十四条:任何个人和组织不得窃取或者以其他非法方式获取个人信息。
- 爬虫合规要点:不得使用技术手段绕过网站的反爬虫措施;不得干扰网站正常运行;遵守网站的Robots协议。
《数据安全法》(2021年9月1日施行)
- 第三十二条:任何个人、组织不得窃取或者以其他非法方式获取数据。
- 第三十六条:非经中华人民共和国主管机关批准,境内的组织、个人不得向外国司法或者执法机构提供存储于中华人民共和国境内的数据。
- 爬虫合规要点:不得爬取国家核心数据、重要数据;数据出境需安全评估。
《个人信息保护法》(2021年11月1日施行)
- 第十三条:处理个人信息应当取得个人同意。
- 第二十八条:敏感个人信息包括生物识别、宗教信仰、特定身份、医疗健康、金融账户、行踪轨迹等,处理敏感个人信息需取得个人的单独同意。
- 爬虫合规要点:爬取个人信息需取得同意;禁止爬取敏感个人信息;不得非法买卖个人信息。
《反不正当竞争法》(2019年修订)
- 第十二条:经营者不得利用技术手段,通过影响用户选择或者其他方式,实施妨碍、破坏其他经营者合法提供的网络产品或者服务正常运行的行为。
- 爬虫合规要点:不得以爬取数据的方式不正当竞争;不得利用爬取的数据损害其他经营者利益。
《刑法》相关条款
| 罪名 | 法条 | 适用场景 |
|---|---|---|
| 非法获取计算机信息系统数据罪 | 第285条第2款 | 绕过安全措施获取数据 |
| 侵犯公民个人信息罪 | 第253条之一 | 非法获取、出售个人信息 |
| 非法侵入计算机信息系统罪 | 第285条第1款 | 侵入国家事务等特定系统 |
| 破坏计算机信息系统罪 | 第286条 | 干扰系统正常运行 |
¶ 3.2 合规爬虫实践
| 合规要点 | 具体要求 | 实施建议 |
|---|---|---|
| 遵守Robots协议 | 不爬取Disallow目录 | 解析robots.txt并严格遵守 |
| 控制请求频率 | 不超过网站承受能力 | 单IP每秒不超过1-2次请求 |
| 不破解技术措施 | 不绕过验证码、不逆向加密 | 遇到验证码停止或寻求合法授权 |
| 数据脱敏 | 不存储个人敏感信息 | 爬取后立即删除敏感字段 |
| 版权声明 | 遵守网站的版权和使用条款 | 阅读并遵守ToS |
| 及时停止 | 收到停止通知后立即执行 | 监控法律函件和封禁通知 |
| 数据用途 | 不用于不正当竞争 | 内部使用,不公开传播 |
¶ 3.3 典型案例
合法案例:hiQ Labs v. LinkedIn(美国,2019-2022)
- 案情:hiQ Labs爬取LinkedIn公开用户资料用于数据分析,LinkedIn发函要求停止并实施技术封锁。
- 判决:美国第九巡回上诉法院认定,爬取公开可访问的数据不违反《计算机欺诈与滥用法》(CFAA)。
- 启示:公开数据的爬取在美国有法律保护,但需遵守网站的ToS和技术措施。
违法案例:字节跳动诉百度爬虫案(中国,2018)
- 案情:百度爬虫大量爬取字节跳动旗下产品的内容,用于百度自身产品。
- 判决:法院认定百度违反Robots协议,构成不正当竞争,判赔50万元。
- 启示:违反Robots协议在中国可能构成不正当竞争。
违法案例:马蜂窝数据造假案(中国,2018)
- 案情:马蜂窝被曝2100万条评论中约1800万条是从竞争对手处爬取并虚假标注。
- 后果:公司声誉严重受损,估值大幅缩水。
- 启示:爬取数据后的虚假标注和商业使用可能涉及多重违法。
违法案例:爬虫获取简历数据案(中国,2021)
- 案情:某科技公司开发爬虫程序,从招聘网站爬取大量求职者简历(含姓名、电话、住址等个人信息),用于自身招聘业务。
- 判决:法院认定构成侵犯公民个人信息罪,判处有期徒刑并处罚金。
- 启示:爬取个人信息(即使部分公开)可能触犯刑法。
¶ 3.4 国际法律对比
| 国家/地区 | 核心法律 | 对爬虫的态度 | 典型案例 |
|---|---|---|---|
| 中国 | 《网络安全法》《数据安全法》《个保法》 | 严格监管 | 字节诉百度案 |
| 美国 | CFAA、DMCA | 公开数据相对宽松 | hiQ v. LinkedIn |
| 欧盟 | GDPR | 个人数据极严格 | 多起GDPR罚款 |
| 日本 | 不正竞争防止法 | 中等严格 | 乐天诉爬虫案 |
| 韩国 | 信息通信网络法 | 较严格 | 多起刑事案例 |
¶ 第四部分:技术选型建议
¶ 4.1 反爬虫方案选型
| 场景 | 推荐方案 | 成本估算(月) | 误杀率 | 防护效果 |
|---|---|---|---|---|
| 小型网站/博客 | Nginx限流 + UA检测 | 免费 | <1% | ⭐⭐ 基础 |
| 中型电商 | WAF + 验证码 + 行为分析 | ¥500-5000 | <0.5% | ⭐⭐⭐ 良好 |
| 大型平台 | 边缘防护 + AI风控 + 设备指纹 | ¥5万-50万 | <0.1% | ⭐⭐⭐⭐⭐ 优秀 |
| 金融/政务 | 全栈防护 + 人工审核 | ¥50万+ | <0.01% | ⭐⭐⭐⭐⭐ 极致 |
成本收益分析模型:
假设某电商平台日均PV为500万,其中恶意爬虫占比15%(75万PV),每次爬取造成$0.01的损失(带宽+数据价值):
- 无防护时损失:
- 基础防护成本:免费,可拦截30%爬虫 → 节省
- 中级防护成本:¥3000/月,可拦截70%爬虫 → 节省
- 高级防护成本:¥10万/月,可拦截95%爬虫 → 节省
ROI计算:
- 基础防护:ROI = ∞(零成本)
- 中级防护:ROI =
- 高级防护:ROI =
对于该场景,中级防护的性价比最高。
¶ 4.2 数据采集方案选型
| 场景 | 推荐方案 | 复杂度 | 开发周期 | 维护成本 | 扩展性 |
|---|---|---|---|---|---|
| 静态页面采集 | requests + BeautifulSoup | ⭐ 低 | 1-2天 | 低 | 中 |
| 动态渲染页面 | Playwright/Puppeteer | ⭐⭐ 中 | 3-5天 | 中 | 中 |
| 大规模分布式采集 | Scrapy + 代理池 + 分布式 | ⭐⭐⭐ 高 | 1-2周 | 高 | 高 |
| 高频实时数据 | 逆向API + 签名算法 | ⭐⭐⭐⭐ 很高 | 2-4周 | 很高 | 高 |
| AI智能采集 | LLM + 视觉理解 | ⭐⭐⭐ 高 | 1-2周 | 中 | 高 |
技术选型决策树:
¶ 4.3 反爬虫技术演进时间线
| 时期 | 爬虫技术 | 反爬虫技术 | 代表事件 |
|---|---|---|---|
| 1990-2000 | 简单HTTP请求 | Robots协议 | 搜索引擎诞生 |
| 2000-2010 | 正则解析HTML | UA检测、IP限流 | Google反制内容农场 |
| 2010-2015 | Selenium/PhantomJS | JS挑战、Cookie验证 | 12306验证码大战 |
| 2015-2020 | Puppeteer/Playwright | 设备指纹、行为分析 | Cloudflare 5秒盾 |
| 2020-2024 | 分布式智能爬虫 | AI风控、WASM保护 | reCAPTCHA v3普及 |
| 2024-至今 | LLM驱动爬虫 | 多模态行为分析 | AI vs AI博弈 |
¶ 第五部分:实战案例
¶ 5.1 构建一个合规的爬虫系统
以下是一个兼顾效率与合规的爬虫系统架构:
# 合规爬虫核心实现
import time
import hashlib
from urllib.robotparser import RobotFileParser
from urllib.parse import urlparse
import requests

class CompliantCrawler:
    """合规爬虫基类"""

    def __init__(self, respect_robots=True, delay=2, max_requests_per_domain=100):
        self.respect_robots = respect_robots
        self.delay = delay
        self.max_requests = max_requests_per_domain
        self.domain_counters = {}
        self.robots_cache = {}
        self.session = requests.Session()
        self.session.headers.update({
            'User-Agent': 'MyBot/1.0 (https://mysite.com/bot; [email protected])'
        })

    def can_fetch(self, url):
        """检查是否可以抓取URL"""
        parsed = urlparse(url)
        domain = parsed.netloc

        # 检查请求次数限制
        if self.domain_counters.get(domain, 0) >= self.max_requests:
            print(f"达到域名请求上限: {domain}")
            return False

        # 检查Robots协议
        if self.respect_robots:
            rp = self._get_robots_parser(domain)
            if not rp.can_fetch('*', url):
                print(f"Robots禁止: {url}")
                return False

        return True

    def _get_robots_parser(self, domain):
        """获取并缓存Robots解析器"""
        if domain not in self.robots_cache:
            rp = RobotFileParser()
            rp.set_url(f"https://{domain}/robots.txt")
            try:
                rp.read()
                self.robots_cache[domain] = rp
            except Exception as e:
                print(f"读取robots.txt失败: {e}")
                # 如果无法读取,默认允许
                self.robots_cache[domain] = None
        return self.robots_cache[domain]

    def fetch(self, url):
        """合规地获取页面"""
        if not self.can_fetch(url):
            return None

        # 频率控制
        time.sleep(self.delay)

        try:
            response = self.session.get(url, timeout=30)
            response.raise_for_status()

            # 更新计数器
            domain = urlparse(url).netloc
            self.domain_counters[domain] = self.domain_counters.get(domain, 0) + 1

            # 记录审计日志
            self._log_request(url, response.status_code)

            return response

        except requests.RequestException as e:
            print(f"请求失败: {url}, 错误: {e}")
            return None

    def _log_request(self, url, status_code):
        """记录审计日志"""
        timestamp = time.strftime('%Y-%m-%d %H:%M:%S')
        print(f"[{timestamp}] URL: {url}, Status: {status_code}")

# 使用示例
crawler = CompliantCrawler(delay=3, max_requests_per_domain=50)
response = crawler.fetch("https://example.com/page")
if response:
    print(response.text[:500])
¶ 5.2 反爬虫系统性能监控
# 反爬虫监控面板数据收集
from dataclasses import dataclass
from typing import Dict, List
import time

@dataclass
class SecurityEvent:
    timestamp: float
    event_type: str  # 'blocked', 'challenged', 'allowed'
    ip: str
    user_agent: str
    path: str
    reason: str
    score: float

class AntiCrawlerMonitor:
    """反爬虫系统监控器"""

    def __init__(self):
        self.events: List[SecurityEvent] = []
        self.metrics_window = 3600  # 1小时窗口

    def record_event(self, event: SecurityEvent):
        """记录安全事件"""
        self.events.append(event)
        self._cleanup_old_events()

    def _cleanup_old_events(self):
        """清理过期事件"""
        cutoff = time.time() - self.metrics_window
        self.events = [e for e in self.events if e.timestamp > cutoff]

    def get_metrics(self) -> Dict:
        """获取当前监控指标"""
        self._cleanup_old_events()

        total = len(self.events)
        blocked = len([e for e in self.events if e.event_type == 'blocked'])
        challenged = len([e for e in self.events if e.event_type == 'challenged'])
        allowed = len([e for e in self.events if e.event_type == 'allowed'])

        return {
            'total_requests': total,
            'blocked': blocked,
            'challenged': challenged,
            'allowed': allowed,
            'block_rate': blocked / total if total > 0 else 0,
            'challenge_rate': challenged / total if total > 0 else 0,
            'top_blocked_ips': self._get_top_blocked_ips(10),
            'top_attacked_paths': self._get_top_attacked_paths(10)
        }

    def _get_top_blocked_ips(self, n: int) -> List[tuple]:
        """获取被拦截最多的IP"""
        from collections import Counter
        blocked_ips = [e.ip for e in self.events if e.event_type == 'blocked']
        return Counter(blocked_ips).most_common(n)

    def _get_top_attacked_paths(self, n: int) -> List[tuple]:
        """获取被攻击最多的路径"""
        from collections import Counter
        paths = [e.path for e in self.events]
        return Counter(paths).most_common(n)
¶ 参考资源
- OWASP Automated Threats
- Scrapy Documentation
- Playwright Documentation
- Puppeteer Stealth Plugin
- ja3 fingerprint
- FingerprintJS
- curl-impersonate
- Cloudflare Bot Management
- Imperva Bad Bot Report 2024
创建时间:2026-04-01
更新日期:2026-06-19
标签:网络安全、数据采集、爬虫技术、反爬虫、合规