¶ Ridge Regression(岭回归)
岭回归(Ridge Regression,又称 Tikhonov 正则化)是线性回归的 L2 正则化版本,通过在损失函数中引入系数平方和的惩罚项,有效缓解过拟合与多重共线性问题。自 Hoerl 和 Kennard 于 1970 年系统提出以来,岭回归已成为统计建模、机器学习和数据分析中最稳定、最常用的线性方法之一。
¶ 问题背景:从 OLS 到正则化
¶ 标准线性回归的局限
普通最小二乘法(OLS)的优化目标为:
其解析解为:
当特征数 接近样本数 ,或特征间存在高度相关性时, 接近奇异(条件数极大),导致以下问题:
- 系数方差剧增:OLS 的系数方差为 ,当 有接近零的特征值时,方差趋于无穷
- 过拟合:模型完美拟合训练噪声,在新数据上表现极差
- 不稳定性:微小输入变化导致系数大幅震荡,预测不可靠
¶ 正则化的核心思想
正则化在损失函数中加入对模型复杂度的惩罚,迫使系数向零收缩(shrinkage):
其中:
- :回归系数向量
- :正则化强度(超参数)
- :L2 范数平方
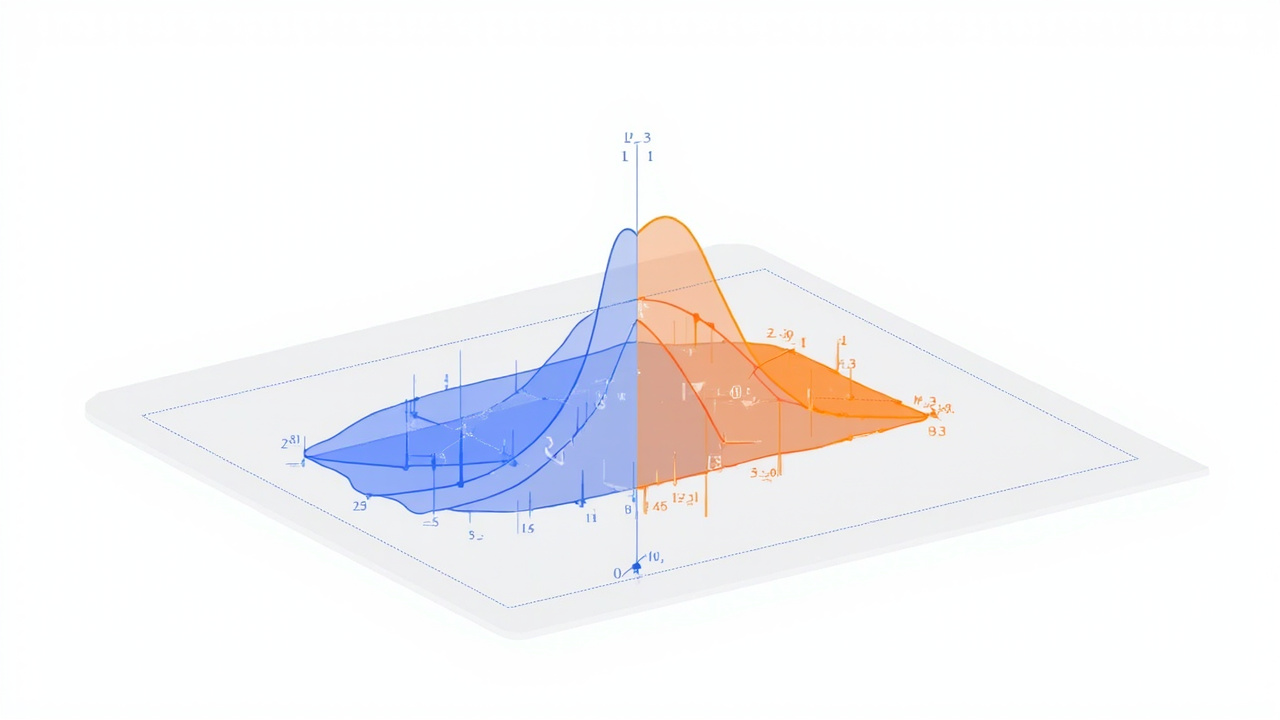
L2 正则化:损失函数的椭圆等高线与 L2 球形约束区域的切点,给出了岭回归的解
在统计学中,正则化等价于对系数施加先验约束。它是 偏差-方差权衡(Bias-Variance Tradeoff)的经典应用——通过引入少量偏差,换取更大的方差降低,从而使总预测误差最小化。
¶ 数学推导
¶ 解析解
对岭回归的目标函数求导并令导数为零,得到闭式解:
其中 是 单位矩阵。对比 OLS 解:
- OLS:
- Ridge:
关键区别:Ridge 在 的对角线上加 ,确保矩阵始终可逆(即使 非满秩),同时缩小了特征值。
¶ 奇异值分解视角
对设计矩阵 做 SVD:,其中 。则:
收缩因子 的作用:
- 大特征值方向():收缩因子 ,几乎不动
- 小特征值方向():收缩因子 ,强烈压缩
这解释了岭回归能有效处理多重共线性的本质原因——它将不稳定的小特征值方向上的噪声信息压缩掉。
¶ 数值示例
假设 个样本, 个高度相关特征:
注意 ,,特征间存在高度共线性。
| 方法 | 条件数 | ||||
|---|---|---|---|---|---|
| OLS () | 0.10 | 0.85 | 1.72 | 3.51 | |
| Ridge () | 0.12 | 0.82 | 1.65 | 3.28 | 45.2 |
| Ridge () | 0.15 | 0.71 | 1.38 | 2.75 | 7.8 |
| Ridge () | 0.28 | 0.32 | 0.58 | 1.12 | 1.9 |
随着 增大,系数显著收缩,条件数从 降至 ,矩阵稳定性大幅提升。
¶ 几何解释
¶ 约束视角
岭回归等价于带约束的优化问题:
图解:损失函数的等高线是椭圆,L2 约束是半径为 的球面。解是椭圆与球面的切点——不一定是 OLS 最优解,但在球约束内的最优解。
¶ 几何直觉
假设有两个特征 和 :
- OLS 的解可能落在距离原点很远的位置(系数很大)
- Ridge 的 L2 球约束将解限制在一个圆形区域内
- 圆形约束导致系数同时收缩但不为零(L2 球是光滑凸集,切点不在坐标轴上)
这与 Lasso(L1 约束形成菱形区域)形成鲜明对比——Lasso 在角点处产生稀疏解(部分系数为零),而 Ridge 保留所有特征。
¶ 偏差-方差权衡
岭回归的本质是在偏差和方差之间寻找最优平衡点。
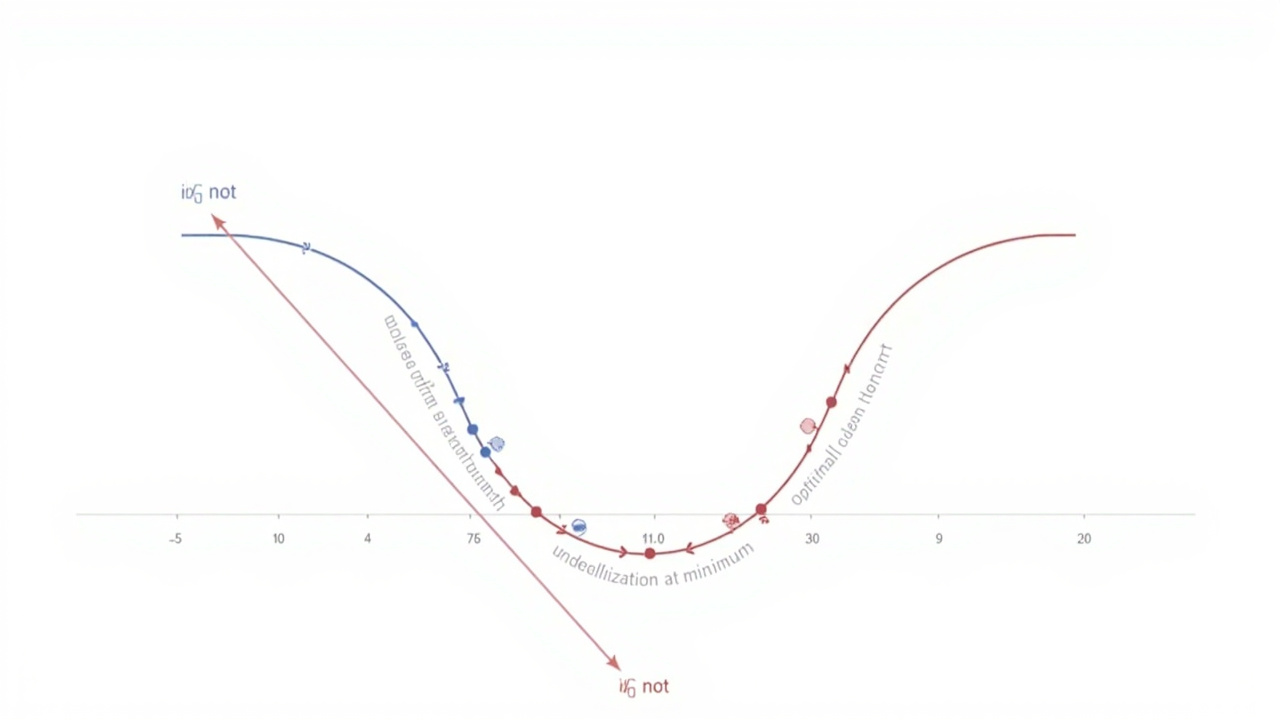
偏差-方差权衡曲线:随着正则化强度增加,偏差逐渐增大而方差快速减小,总预测误差呈现 U 型,最低点对应最优 选择
在不同 下,偏差和方差的变化规律:
| 偏差 | 方差 | 总误差 | 适用场景 | |
|---|---|---|---|---|
| 0(无偏) | 最大 | 高(过拟合) | 且无共线性 | |
| 轻微 | 大幅降低 | 降低 | 常见选择 | |
| 可接受 | 显著降低 | 最低 | 最优 | |
| 过大 | 小幅降低 | 回升(欠拟合) | 先验强或噪声极大 |
¶ 正则化路径与超参数选择
¶ 正则化路径
随着 从 增至 ,岭回归的系数不断变化形成正则化路径。这是一个连续平滑的曲线——与 Lasso 不同,Ridge 的所有系数同时收缩但不归零。
¶ 选择最优
¶ 1. K 折交叉验证(K-Fold CV)
将数据分为 K 份(通常 K=5 或 10),每份轮流做验证集,选择使平均验证误差最小的 :
for λ in candidate_values:
    for fold k in 1..K:
        在 K-1 份上拟合 Ridge(λ)
        在剩余 1 份上计算 MSE
    CV_error[λ] = mean(MSE over K folds)
λ* = argmin CV_error[λ]
¶ 2. 留一交叉验证(LOOCV)
当 较小时,留一交叉验证是更好的选择。对岭回归,LOOCV 有简洁的闭式公式:
其中 是帽子矩阵, 是其对角线元素。
¶ 3. 广义交叉验证(GCV)
GCV 用迹近似代替逐项计算,计算效率远高于 LOOCV:
¶ Python 实践
¶ 使用 scikit-learn
import numpy as np
from sklearn.linear_model import Ridge, RidgeCV
from sklearn.preprocessing import StandardScaler

# 生成含共线性的合成数据
np.random.seed(42)
n, p = 100, 20
X = np.random.randn(n, p)
# 引入共线性
for j in range(1, p):
    X[:, j] = X[:, 0] + 0.1 * np.random.randn(n)

true_beta = np.random.randn(p) * 0.5
y = X @ true_beta + 0.5 * np.random.randn(n)

# 标准化(岭回归对尺度敏感)
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

# 交叉验证选择最优 lambda
ridge_cv = RidgeCV(
    alphas=np.logspace(-3, 3, 50),
    scoring='neg_mean_squared_error',
    cv=5
)
ridge_cv.fit(X_scaled, y)

print(f"最优 lambda: {ridge_cv.alpha_:.4f}")
print(f"R² 分数: {ridge_cv.score(X_scaled, y):.4f}")

# 不同 lambda 下的系数范数
for lam in [0.01, 0.1, 1.0, 10.0, 100.0]:
    ridge = Ridge(alpha=lam)
    ridge.fit(X_scaled, y)
    coef_norm = np.linalg.norm(ridge.coef_, 2)
    print(f"λ={lam:6.2f} → ||β||₂ = {coef_norm:.4f}")
输出示例:
最优 lambda: 1.2457
R² 分数: 0.8234
λ=  0.01 → ||β||₂ = 3.2145
λ=  0.10 → ||β||₂ = 2.8893
λ=  1.00 → ||β||₂ = 1.8752
λ= 10.00 → ||β||₂ = 0.8761
λ=100.00 → ||β||₂ = 0.3214
¶ 手动实现
def ridge_regression(X, y, lambda_val):
    """
    岭回归的闭式解实现

    Parameters:
    X: (n, p) 设计矩阵
    y: (n,) 目标向量
    lambda_val: 正则化强度

    Returns:
    beta: (p,) 系数向量
    """
    n, p = X.shape
    I = np.eye(p)
    beta = np.linalg.solve(X.T @ X + lambda_val * I, X.T @ y)
    return beta

# 验证手动实现与 sklearn 一致性
beta_manual = ridge_regression(X_scaled, y, lambda_val=1.0)
beta_sklearn = Ridge(alpha=1.0).fit(X_scaled, y).coef_
print(f"最大差异: {np.max(np.abs(beta_manual - beta_sklearn)):.2e}")
¶ 贝叶斯解释
岭回归有优雅的贝叶斯解释:对系数施加高斯先验 ,Ridge 解对应后验分布的众数(MAP 估计)。
此时 。这个视角解释了岭回归为什么倾向于较小的系数——这正是高斯先验的收缩效应。
¶ 与其他正则化方法的对比
¶ Ridge vs Lasso vs Elastic Net
| 特性 | Ridge (L2) | Lasso (L1) | Elastic Net |
|---|---|---|---|
| 惩罚项 | |||
| 解的形状 | 圆形约束 | 菱形约束 | 混合约束 |
| 特征选择 | 否(所有系数非零) | 是(部分系数为零) | 是(分组选择) |
| 解的形式 | 闭式解 | 需迭代优化 | 需迭代优化 |
| 共线组处理 | 系数均匀收缩 | 只选一个特征 | 组内均匀 + 组间选择 |
| 计算复杂度 | |||
| 情况 | 唯一解( 维) | 至多 个非零 | 至多 个非零 |
¶ 解路径对比
假设有两个相关特征 ,相关系数为 0.9:
- Ridge(L2): 均匀收缩,路径沿对角线直线向原点收缩
- Lasso(L1): 竞争选择,先收缩一个至零,再收缩另一个
- Elastic Net:介于两者之间,保留分组强相关性
¶ 扩展:Kernel Ridge Regression
通过核技巧将岭回归扩展到非线性空间:
其中 , 为核矩阵。KRR 保留了 Ridge 闭式解的优势,同时通过核函数捕捉非线性关系。
¶ 实用建议
¶ 何时使用 Ridge
| 场景 | Ridge 适用性 |
|---|---|
| ,无共线性 | 可选(与 OLS 接近) |
| ,有共线性 | ✅ 强烈推荐 |
| ✅ 适合 | |
| ✅ 唯一可逆解 | |
| 需要特征选择 | ❌ 不适合(用 Lasso) |
| 需要高可解释性 | ✅ 适合(系数稳定) |
¶ 超参数调优指南
- 候选 范围:对数尺度搜索
- 验证方法:时间序列数据用前向验证(walk-forward),横截面数据用 K-fold
- 特征标准化:输入特征必须标准化(均值为 0,方差为 1),否则惩罚项偏向高尺度特征
- 截距处理:截距 通常不参与正则化,需先中心化 和
¶ 常见陷阱
- 未标准化特征:若特征尺度差异大(如一个在 ,另一个在 ),L2 惩罚不对等地压制小尺度特征
- 时序数据泄露:时间序列回测时,必须使用滚动窗口而非随机 K-fold
- 过大:过度收缩使有信号的特征被压制,导致欠拟合
- 忽视截距:某些实现默认不对截距正则化,需确认 API 行为
¶ 相关概念
- Lasso 回归:L1 正则化,适用于特征选择
- Elastic Net:组合 L1 + L2 正则化
- 主成分回归(PCR):先降维后回归的替代方法
- 偏差-方差权衡:理解正则化的核心框架
优化于:2026-07-02