¶ 可伸缩架构:互联网高并发系统的设计与实现
《可伸缩架构》读书笔记与实战扩展 — 从理论到实践的全面可伸缩性指南
¶ 概述
可伸缩架构(Scalable Architecture)是互联网系统的核心能力之一,指系统能够通过增加资源(硬件、节点)来处理不断增长的负载,同时保持性能和可用性。对于现代互联网应用而言,可伸缩性不是可选项,而是生存必需品——从初创公司的小规模系统到亿级用户平台的演进,每一步都考验着架构的可伸缩设计能力。
本文以陈斌《可伸缩架构:互联网高并发系统的设计与实现》一书为核心框架,结合业界经典实践(如 Amazon 弹性设计原则、Google Borg/Werner Vogels 分布式理念),系统性阐述可伸缩架构的关键技术、设计模式与实施方法。
¶ 可伸缩性的三阶段演进
互联网系统的可伸缩性演进通常经历三个阶段:
| 阶段 | 典型规模 | 架构特征 | 伸缩方式 | 关键挑战 |
|---|---|---|---|---|
| 单体初创期 | QPS < 1,000 | 单应用 + 单数据库 | 垂直扩展(升级硬件) | 数据库连接数、应用内存 |
| 服务化拓展期 | QPS 1,000–100,000 | 微服务 + 读写分离 | 水平扩展(增加实例) | 服务治理、数据一致性 |
| 超大规模期 | QPS > 100,000 | 单元化 + 异地多活 | 单元化扩展 | 全局路由、数据同步、多活容灾 |
Amazon 在 2000 年代初期经历了这一完整演进:从简单的 LAMP 栈起步,经过 SOA 服务化转型,最终打造了全球最大规模的微服务生态系统。其 CTO Werner Vogels 提出的"分布式计算的 10 条经验"至今仍是可伸缩架构的黄金准则。
¶ 一、可伸缩性的核心概念
¶ 1.1 伸缩性 vs 高性能 vs 高可用
这三者常被混为一谈,但存在本质区别:
| 维度 | 关注点 | 典型手段 | 衡量指标 |
|---|---|---|---|
| 高性能 | 单个请求的响应速度 | 缓存、索引、CDN、异步化 | P50/P99 延迟 |
| 高可用 | 系统持续可用 | 冗余、故障转移、多活 | SLA(可用性百分比) |
| 可伸缩 | 承载更多流量 | 水平扩展、分片、无状态设计 | 吞吐量-资源曲线斜率 |
可伸缩性是三者之间的桥梁——没有伸缩性,高性能和高可用都无法持续。一个只能单机运行的系统,即使性能再好、可用性再高,也禁不起千万级流量的冲击。
可伸缩性金字塔:高性能关注响应速度,高可用关注持续可用,可伸缩关注承载能力——三者层层递进,缺一不可
¶ 1.2 伸缩性的两类问题
Scale Up(垂直扩展):
- 升级单机硬件(CPU、内存、磁盘)
- 优点:无需修改代码,应用程序不需要做任何改造
- 缺点:物理瓶颈明显(单机有上限),成本非线性增长(高端服务器的边际成本远高于普通机器)
- 典型数据:一台 128 核服务器价格约是 8 台 16 核服务器的 3-4 倍,但性能仅为其 60-70%
Scale Out(水平扩展):
- 增加机器数量,分布式协同处理
- 优点:理论上无限扩展,成本线性增长,支持弹性伸缩
- 缺点:引入分布式一致性、数据分片、服务发现、负载均衡等复杂度
实践原则:"Scale Out first, Scale Up when must"——优先水平扩展,仅在必要时垂直升级。以下决策树可帮助选择:
¶ 1.3 Amdahl 定律与可伸缩上限
Amdahl 定律揭示了并行化扩展的理论上限:
其中 是加速比, 是可以并行化的比例, 是处理器数量。
具体数值示例:如果一个系统中 90% 的操作可并行化(),10% 需串行执行:
| 处理器数 | 理论加速比 | 实际效率 |
|---|---|---|
| 1 | 1.00× | 100% |
| 10 | 5.26× | 52.6% |
| 50 | 8.33× | 16.7% |
| 100 | 9.17× | 9.2% |
| 1000 | 9.91× | 0.99% |
关键洞察:即使只有 10% 的串行部分,当扩展到 100 个节点时效率已不足 10%。这就是为什么减少串行化瓶颈(如分布式锁、全局计数器)是设计可伸缩系统最核心的工作之一。
实践含义:
- 将不可并行操作限制在最小范围
- 通过异步化将"伪串行"转为"实质并行"
- 使用最终一致性替代强一致性来减少同步点
¶ 二、无状态化:可伸缩的基石
¶ 2.1 有状态 vs 无状态
| 特性 | 有状态服务 | 无状态服务 |
|---|---|---|
| 请求路由 | 必须路由到同一节点 | 任意节点均可处理 |
| 弹性扩缩 | 需要 Session 迁移 | 直接加减节点 |
| 故障恢复 | 需恢复状态 | 重启即恢复 |
| 调试难度 | 状态相关 Bug 难复现 | 容易复现和调试 |
| 典型实现 | Session 绑定、状态对象 | RESTful API、函数式计算 |
核心原则:业务逻辑层保持无状态,状态下沉到中间件层(如 Redis、数据库、对象存储)。
¶ 2.2 实践中如何实现无状态化
¶ Session 改造方案
| 方案 | 实现方式 | 优点 | 缺点 | 推荐度 |
|---|---|---|---|---|
| Sticky Session | 负载均衡按 Session 路由 | 简单 | 节点重启丢失、扩缩需迁移 | ⭐⭐ |
| Session 复制 | 节点间广播复制 | 可用性高 | 网络开销大、时效性差 | ⭐ |
| 集中式存储 | 存入 Redis/Memcached | 真正无状态、弹性扩缩 | 多一次网络调用 | ⭐⭐⭐⭐⭐ |
| Client Token | JWT/Token | 完全去中心化 | Token 不可控、Payload 有限 | ⭐⭐⭐⭐ |
推荐做法:
- Session 数据存入 Redis/Memcached,应用层只存 Session ID
- 使用 JWT 等 token 机制,状态自包含在客户端
- 接入层用一致性哈希路由,优先本地缓存,miss 后查共享存储
¶ 配置与元数据
配置文件从代码中剥离,推送到配置中心:
好处:同一份代码包可在开发、测试、生产环境无缝运行,启动时拉取、运行时热更新。
¶ 2.3 无状态化的收益
- 弹性扩缩:随时加减节点,无需 session 迁移
- 故障隔离:单节点故障不影响整体
- 灰度发布:部分节点更新,流量逐步切换
- 水平扩展:理论上无限扩展,只需做好负载均衡
¶ 三、负载均衡:流量分发的第一道关卡
¶ 3.1 负载均衡的层级
¶ DNS 负载均衡
- 原理:DNS 轮询,同一个域名解析到多个 IP
- 优点:天然免费,全局可用
- 缺点:无法感知后端健康状态,DNS 缓存更新慢
- 适用:多数据中心入口流量分发
- TTL 建议:常规情况 60s,高可用场景 5-10s
¶ 四层负载均衡(LVS、F5)
- 原理:传输层(IP+端口),转发 TCP/UDP 包
- 性能:单机可达百万级并发连接
- 优点:性能极高,协议无关
- 缺点:无法基于 HTTP 头部做高级路由
- 适用:流量入口,TLS 终结前的转发
¶ 七层负载均衡(Nginx、HAProxy、Envoy)
- 原理:应用层,可解析 HTTP 头部、Cookie、URI
- 优点:路由策略丰富(URL 级、Header 级、Cookie 级)
- 缺点:性能低于四层(通常为四层的 50-70%)
- 适用:微服务网关、API 路由、灰度策略
七层 vs 四层性能基准(在同等硬件上):
| 指标 | 四层(LVS) | 七层(Nginx) |
|---|---|---|
| 纯转发吞吐 | 5-10 Gbps | 1-3 Gbps |
| 最大并发连接 | 500万+ | 10万-50万 |
| P99 延迟增量 | <1ms | 1-5ms |
| 健康检查能力 | 基本(端口级) | 丰富(HTTP 探活) |
¶ 3.2 路由算法选择
负载均衡分层架构:从 DNS 全局负载均衡到四层 LVS 流量转发,再到七层 Nginx 应用层路由,层层递进构成完整的流量分发链路
| 算法 | 特点 | 缺点 | 适用场景 |
|---|---|---|---|
| 轮询 | 均匀分发,实现简单 | 不考虑节点负载差异 | 同规格节点集群 |
| 加权轮询 | 按权重分配 | 权重配置需手动调整 | 异构集群 |
| 最少连接 | 动态感知连接数 | 状态收集有延迟 | 长连接场景 |
| 一致性哈希 | 请求/用户固定路由到节点 | 节点增减只影响部分 key | 缓存、Session 亲和 |
| 随机 | 简单、均匀 | 节点数少时不均匀 | 大数据量场景下趋于均匀 |
一致性哈希详解:当需要保持请求到同一后端时(如本地缓存),一致性哈希是最佳选择。其核心思想是将节点和数据映射到同一个哈希环上,节点的增减只影响相邻节点。
虚拟节点优化:每个物理节点在哈希环上创建多个虚拟节点(如 150 个),使数据分布更均匀,节点增减时影响面更小。
¶ 3.3 健康检查与故障剔除
负载均衡器必须配置健康检查,自动剔除故障节点:
- 被动检查:连续 N 次请求失败,标记为不健康(如 Nginx proxy_next_upstream)
- 主动检查:定期发送探活请求,根据响应码/内容判定健康状态(如 Nginx health_check)
- 慢启动:新加入节点逐步增加流量,避免缓存冷启动导致雪崩
推荐配置:
# Nginx 主动健康检查示例
upstream backend {
    zone backend 64k;
    server 10.0.0.1:8080 max_fails=3 fail_timeout=30s;
    server 10.0.0.2:8080 max_fails=3 fail_timeout=30s;

    # 慢启动 60s,逐步接入新节点
    server 10.0.0.3:8080 slow_start=60s;
}

# 主动健康检查(需 nginx-plus 或 nginx-ultimate)
match backend_health {
    status 200;
    header Content-Type ~ "application/json";
    body ~ "ok";
}
¶ 四、缓存策略:性能与成本的最优平衡
¶ 4.1 缓存的核心原则:金字塔模型
金字塔原则:越靠近用户的数据,应放在越快(也越贵)的存储中。每一层的作用是过滤掉对下一层的访问。
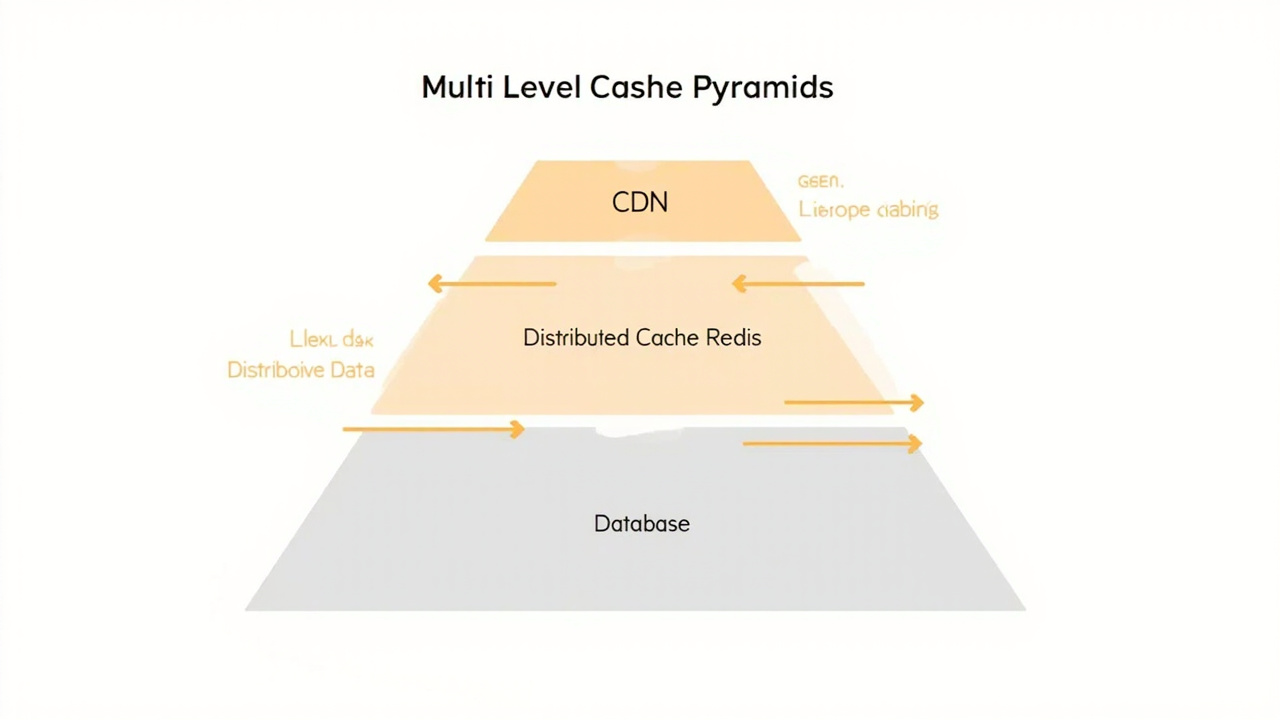
缓存金字塔:从 CDN 到本地缓存、分布式缓存、磁盘缓存到数据库,延迟逐级增加,容量逐级增大
缓存各层命中率对延迟的影响(以 P99 为例):
| 场景 | CDN命中 | CDN miss+本地命中 | 全miss |
|---|---|---|---|
| P99 延迟 | 200ms | 500ms | 3-5s |
| 服务器负载 | 极低 | 低 | 高 |
¶ 4.2 多级缓存实践
¶ CDN 缓存
- 静态资源(图片、CSS、JS)全量 CDN
- 动态内容可通过 ESI(Edge Side Includes)部分缓存
- 设置合理的 TTL 和版本号策略,避免缓存一致性问题
- 版本号策略:
app.js?v=20240601实现版本更新时的即时缓存刷新
¶ 本地缓存(应用内)
- 使用 Caffeine(Java)、groupcache(Go)、lru_cache(Python)
- 适合读多写少、数据量小、一致性要求不高的场景
- TTL 设置不宜过长(秒级到分钟级)
- Caffeine 性能基准:加载 1000 万 key,读写 P99 < 1μs
¶ 分布式缓存(Redis Cluster / Redis Sentinel)
三大经典问题与解决方案:
缓存穿透——查询不存在的数据绕过缓存直击 DB:
- 布隆过滤器:在缓存前再挡一层,拦截不存在 key
- 空值缓存:即使查到空结果也缓存,TTL 设为短时间(30-60s)
缓存雪崩——大量缓存同时过期:
- 过期时间加随机偏移:
expire = base_ttl + random(0, 600)防止集体过期 - 本地缓存兜底:即使 Redis 挂了,用本地缓存或限流保护 DB
缓存击穿——单个热点 key 过期后高并发请求:
- 互斥锁:第一个请求重建缓存,后续等待
- 提前续期:监控 key 的访问频率,在过期前自动续期
¶ 4.3 缓存更新的最佳实践
推荐:Cache Aside Pattern
读操作:
  1. 从缓存读取 → 命中则返回
  2. 未命中 → 从数据库读取
  3. 写入缓存(设置 TTL)
  4. 返回结果

写操作:
  1. 先写入数据库
  2. 删除缓存(而不是更新缓存)
为什么不更新缓存?
假设有两个并发写操作:
- 写 A:value = "A" → 写入 DB → 更新缓存为 "A"
- 写 B:value = "B" → 写入 DB → 更新缓存为 "B"
正常情况结果正确。但考虑时间交错:
- 写 A 更新缓存(value = "A")—— 时间 t1
- 写 B 写入 DB(value = "B")—— 时间 t2
- 写 B 更新缓存(value = "B")—— 时间 t3
- 写 A 写入 DB(value = "A")—— 时间 t4(未按预期顺序!)
结果:DB 中是 "A",缓存中是 "B" —— 数据不一致!
删除缓存策略避免了这个问题:下一次读取时从 DB 重新加载,必然读到最新值。
延迟双删策略(读多写少场景的增强):
写入 DB → 删除缓存 → 延迟 N ms → 再次删除缓存
该策略确保在"读-写"并发场景下,即使旧值被重新写入缓存,也会被第二次删除清掉。
¶ 4.4 缓存容量规划
| 指标 | 建议 | 说明 |
|---|---|---|
| 热点数据总量 | 预留 30-50% 缓冲区 | 防止突发流量塞满缓存 |
| 大 key 上限 | 单个 value < 10KB | 大 value 影响序列化和网络传输 |
| 缓存命中率 | 目标 > 90%,低于 85% 需排查 | 命中率低说明缓存未起到应有的作用 |
| 内存分配 | Redis 总内存 ≤ 物理内存 70% | 预留足够内存给系统和其他进程 |
| maxmemory-policy | allkeys-lru | 内存满时自动淘汰不常用 key |
¶ 五、数据库伸缩:从单库到分布式
¶ 5.1 读写分离
架构:主库处理写操作,从库处理读操作,通过主从复制同步。
实施要点:
- 写操作强制走主库,读操作根据场景选择
- 读写分离网关:对应用层透明(如 MySQL Router、ShardingSphere)
- 主从延迟问题:对一致性敏感的读操作,可设置"读主策略"或等待延迟窗口
- 从库负载:简单的轮询或更复杂的最小连接数策略
主从延迟量化(典型数据):
| 场景 | 平均延迟 | P99延迟 | 最大延迟 |
|---|---|---|---|
| 同机房 | < 1ms | 5ms | 10ms |
| 同城跨机房 | 1-5ms | 20ms | 100ms |
| 跨地域 | 10-100ms | 200ms | 500ms+ |
对于要求强一致的场景(如支付、库存扣减),必须读主库。
¶ 5.2 分库分表
¶ 垂直分片 vs 水平分片
| 维度 | 垂直分片 | 水平分片 |
|---|---|---|
| 拆分方式 | 按业务域(用户库/订单库/商品库) | 按数据行(用户ID取模到32个库) |
| 复杂度 | 较低 | 较高 |
| 跨库事务 | 需分布式事务 | 同一分片内可避免 |
| 数据倾斜 | 各库负载可能差异大 | 分片键设计好则均匀 |
| 扩展上限 | 业务域数量有限 | 理论上无限 |
¶ 垂直分片示例
┌─ order_db ─┐    ┌─ user_db ─┐    ┌─ product_db ─┐
│ orders     │    │ users     │    │ products    │
│ order_items│    │ addresses │    │ categories  │
│ payments   │    │ coupons   │    │ inventory   │
└─────────────┘    └─────────────┘    └──────────────┘
¶ 水平分片策略
分片键的选择——最关键的设计决策:
| 分片键 | 优点 | 缺点 |
|---|---|---|
| 用户 ID | 天然均匀,用户相关操作集中 | 热点用户问题,跨用户查询跨分片 |
| 时间 | 按时间分片直观 | 热点集中在最新时间,历史数据空洞 |
| 哈希 | 数据分布最均匀 | 范围查询困难,扩容需重新分布 |
数值对比:
假设 1 亿用户,每日 1000 万订单,分 64 个库,每个库分 8 张表:
总表数 = 64 × 8 = 512 张表
每张表数据量 = 1亿 × 30天 / 512 ≈ 586 万行
| 分片键 | 数据均衡度 | 查询受限性 | 扩容难度 |
|---|---|---|---|
| user_id % 64 | ⭐⭐⭐⭐⭐ 均匀 | 必须带 user_id | ⭐⭐ 2倍扩容 |
| order_id % 64 | ⭐⭐⭐⭐⭐ 均匀 | 必须带 order_id | ⭐⭐ 2倍扩容 |
| 按日期范围 | ⭐⭐ 不均匀 | 范围查询友好 | ⭐⭐⭐ 加新表即可 |
| 按地理区域 | ⭐ 不对称 | 区域查询优 | ⭐⭐⭐ 加区域即可 |
¶ 5.3 分库分表的陷阱
- 跨分片查询:JOIN、聚合、排序需在应用层或中间件层完成
- 分布式事务:X/Open XA 方案性能差,推荐 TCC、Saga、最终一致性 + 补偿
- 全局唯一 ID:雪花算法(Snowflake)最常见,也可用发号器服务
- 扩容难题:2N 扩容(成倍扩容降低迁移成本),或一致性哈希减少影响
- 数据迁移:不停机迁移方案(双写 + 校验 + 切换)
不停机分片扩容流程:
整个过程需数小时,涉及数亿数据的校验,需配合自动化工具。
¶ 5.4 NoSQL 的合理定位
关系型数据库不是万能药。以下场景考虑 NoSQL:
| 场景 | 推荐引擎 | 关系型数据库劣势 |
|---|---|---|
| KV/缓存/Session | Redis | 行存储不适合简单 KV |
| 动态 Schema/JSON | MongoDB | 表结构变更成本高 |
| 时序/日志/写密集型 | HBase、Cassandra、ClickHouse | 单机写入瓶颈 |
| 全文搜索 | Elasticsearch | LIKE 查询性能极差 |
| 图关系(社交、推荐) | Neo4j | 多表 JOIN 性能不可接受 |
混合架构:MySQL 做主存储 + Elasticsearch 做搜索 + Redis 做缓存 + ClickHouse 做分析,各取所长。
¶ 六、异步处理与消息队列
¶ 6.1 同步 vs 异步
同步调用的问题:
- 耦合性高:调用方必须等待被调用方
- 脆弱性:下游故障直接影响上游
- 性能受限:整体吞吐受最慢链路制约
数值案例:
假设一个下单流程包含 5 个同步步骤:校验(50ms) → 库存扣减(20ms) → 支付(200ms) → 物流推送(100ms) → 通知(30ms)
- 同步模式总耗时 = 50 + 20 + 200 + 100 + 30 = 400ms(串行)
- 如果其中库存扣减和物流推送可并行:50 + 20 + max(200, 100) + 30 = 300ms
- 异步模式(MQ):校验 + 发送消息 = 50ms 返回,后续异步处理
¶ 6.2 消息队列选型
| 参数 | RabbitMQ | Kafka | RocketMQ | Pulsar |
|---|---|---|---|---|
| 吞吐量 | 万级/秒 | 百万级/秒 | 十万级/秒 | 百万级/秒 |
| 延迟 | 微秒级 | 毫秒级 | 毫秒级 | 毫秒级 |
| 消息可靠性 | 高(确认机制) | 高(副本机制) | 高(同步刷盘) | 高(BookKeeper) |
| 顺序消息 | 单队列支持 | 分区内有序 | 强顺序 | 分区内有序 |
| 延迟消息 | 死信交换机实现 | 不支持原生 | 18个延迟级别 | 支持 |
| 运维复杂度 | 低 | 中 | 中 | 高 |
| 客户端生态 | 多语言成熟 | 多语言成熟 | Java为主 | 多语言完善 |
¶ 6.3 消息队列使用原则
- 幂等消费:消费者必须能处理重复消息(用去重表或业务 ID 幂等)
- 死信队列:重试多次失败的消息进入死信,人工或自动补偿处理
- 消息不丢失:生产者确认 + 消费者 ACK + 持久化存储
- 延迟消息:使用 RabbitMQ 死信交换机或 RocketMQ 延迟级别
- 顺序消费:确保同一业务 ID 的消息进入同一分区
幂等消费实现示例:
消费流程:
  1. 解析消息,提取业务唯一 ID(如 order_id)
  2. 查询去重表(Redis SET 或 DB 去重表)
     - 已存在 → 直接 ACK,不处理
     - 不存在 → 插入去重记录 → 执行业务逻辑 → ACK
  3. 确保去重记录的插入与业务逻辑在同一事务中
¶ 七、容量规划与压测
¶ 7.1 容量规划的步骤
- 业务预测:根据历史数据和业务目标预估未来流量
- 压测摸底:单机能承载多少 QPS?
- 资源计算:根据单机容量 ×(1 + 冗余比例)计算所需节点数
- 制定扩容计划:正常扩容阈值、紧急扩容阈值
- 持续监控:实际流量 vs 预测 vs 容量,持续校准
容量估算数值示例:
假设业务预测下月峰值 QPS 为 50,000,经过压测得知单机可承载 2,000 QPS:
基础节点数 = 50,000 / 2,000 = 25
冗余比例(应对突发)= 25 × 30% = 7.5
实际部署节点数 = 25 + 8 = 33

扩容触发阈值 = 2,000 × 70% ≈ 1,400 QPS/节点
当单机 QPS 持续 5 分钟 > 1,400 → 扩容
¶ 7.2 压测方法论
| 压测类型 | 目标 | 工具 | 持续时间 |
|---|---|---|---|
| 单机压测 | 摸清单节点上限 | ab、wrk、hey | 5-10 min |
| 全链路压测 | 端到端性能验证 | JMeter、Locust | 30-60 min |
| 容量测试 | 找到拐点(吞吐不再线性增长的点) | Gatling、k6 | 20-30 min |
| 稳定性测试 | 长时间加压发现内存泄漏、GC 问题 | JMeter + Profiling | 24-72 h |
| 异常测试 | 降级、熔断、限流验证 | Chaos Engineering | 1-2 h |
全链路压测关键注意事项:
- 流量隔离:压测流量必须标记,与真实流量区分
- 数据隔离:使用影子表或影子库,避免污染生产数据
- 风险控制:设置熔断阈值,一旦系统过载立即停止
- 结果分析:关注 P50、P95、P99、P999 各百分位延迟
¶ 7.3 扩容的自动化和策略
Kubernetes HPA 配置示例:
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: scalable-service-hpa
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: scalable-service
  minReplicas: 3
  maxReplicas: 50
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 70
  behavior:
    scaleUp:
      stabilizationWindowSeconds: 300  # 5分钟冷却
      policies:
      - type: Percent
        value: 100    # 每次最多翻倍
        periodSeconds: 60
    scaleDown:
      stabilizationWindowSeconds: 900  # 15分钟冷却
      policies:
      - type: Percent
        value: 25     # 每次最多缩容25%
        periodSeconds: 60
¶ 7.4 过载保护的三道防线
 ┌────────────────────────────────────────────────┐
 │ ① 限流(流量入口)                               │
 │ → 控制请求进入速率,防止系统被突发流量击垮          │
 │ → 全局限流(Guava RateLimiter、Sentinel)        │
 │ → 应用层限流(漏桶、令牌桶、滑动窗口)              │
 └────────────────────────────────────────────────┘
                        ↓
 ┌────────────────────────────────────────────────┐
 │ ② 降级(非核心服务)                             │
 │ → 牺牲局部保全局,返回兜底数据                    │
 │ → 第三方依赖超时调短,避免阻塞                    │
 │ → 页面降级为静态版本                             │
 └────────────────────────────────────────────────┘
                        ↓
 ┌────────────────────────────────────────────────┐
 │ ③ 熔断(下游故障)                               │
 │ → 快速失败,防止级联                             │
 │ → 错误率阈值触发 → 开启熔断 → 恢复后半开试探       │
 └────────────────────────────────────────────────┘
限流算法对比:
| 算法 | 突发支持 | 准确性 | 实现复杂度 | 典型工具 |
|---|---|---|---|---|
| 令牌桶 | ✅ 允许突发 | 高 | 低 | Guava RateLimiter |
| 漏桶 | ❌ 强制平滑 | 高 | 低 | Nginx limit_req |
| 滑动窗口 | ✅ 精细控制 | 最高 | 中 | Sentinel |
| 自适应限流 | ✅ 动态调整 | 中 | 高 | 自定义实现 |
| 漏斗算法 | ❌ 严格平滑 | 中 | 低 | Redis 队列 |
熔断器状态机:
¶ 八、实战案例与经验总结
¶ 8.1 高并发系统典型架构
¶ 8.2 从零到百万 QPS 的演进路线
| 阶段 | QPS 范围 | 架构特征 | 关键动作 |
|---|---|---|---|
| 1. 单机起步 | < 1,000 | 一台应用服务器 + 单库 | 单体应用,快速迭代 |
| 2. 读写分离 | 1,000 ~ 10,000 | 一主多从,读从库写主库 | 引入缓存 Redis |
| 3. 缓存介入 | 1万 ~ 10万 | Redis 扛热点数据 | 升级负载均衡、引入 CDN |
| 4. 分库分表 | 10万 ~ 50万 | 按业务分库,按 ID 分表 | 引入消息队列解耦 |
| 5. 异步微服务 | 50万 ~ 100万 | MQ 削峰填谷,服务拆分 | 服务治理、链路追踪 |
| 6. 异地多活 | 100万+ | 单元化架构,多数据中心 | 单元化路由、全局一致性 |
¶ 8.3 扩容策略速查表
| 场景 | 推荐的伸缩策略 | 典型案例 |
|---|---|---|
| 读多写少(内容型) | 加缓存 + 加从库 | 新闻网站、博客平台 |
| 写多读少(日志型) | 队列缓冲 + 批量写入 + 分片 | 埋点日志、IoT 数据 |
| 热点集中(秒杀) | 本地缓存 + 限流 + 异步扣减 | 电商秒杀、抢票 |
| 时间序列数据 | 时间分片 + 归档 + ClickHouse | 监控指标、交易记录 |
| 全局查询需求 | ES 做二级索引 + 客户端分片 | 搜索、报表 |
| 全球化部署 | 多区域部署 + 全局负载均衡 | 社交平台、游戏 |
¶ 8.4 需要注意的反模式
| 反模式 | 问题 | 正确做法 | 触发条件 |
|---|---|---|---|
| 过早分库分表 | QPS 不到 5000 就分库,引入不必要复杂度 | 先做缓存和读写分离,压测证明单库扛不住再分 | QPS < 5万 |
| 过度缓存 | 数据一致性比性能问题更严重 | 缓存只用于热点、不变或少变数据 | 命中率 < 50% |
| 盲目信从指标 | 没有压测数据支撑的伸缩决策是拍脑袋 | 基于压测数据做容量规划 | 决策无数据 |
| 忽略运维成本 | 引入新组件后没有对应的自动化运维能力 | 每引一个新组件,配套建设运维能力 | 运维人力不足 |
| 贪多求全 | 一个系统塞进所有技术栈 | 按需引入,能少则少 | 技术栈种类 > 6 |
| 忽视预热 | 新节点刚上线就被高并发请求打爆 | 慢启动 + 逐步接入流量 | 重启后缓存/Cold start |
| 不做回滚预案 | 灰度发布失败无法快速回滚 | 每次发布保留回滚能力 | 无前版本备份 |
¶ 8.5 真实案例:微博秒级扩容
2014 年双十一期间,微博遭遇了史无前例的流量洪峰。其系统从凌晨开始持续攀升,原始容量只能支撑预期负载的 40%。微博团队通过以下操作实现了20 分钟内扩容一倍的壮举:
- 缓存预热:提前将热点数据加载到 Redis
- 自动化扩容:通过 CMDB 系统自动申请虚拟机并部署代码
- 策略降级:非核心功能(如推荐、好友动态)暂时降级
- 限流保护:对超出系统处理能力的请求直接限流
关键数据:
- 扩容前:500 台应用服务器,QPS 100万
- 扩容后:1000 台应用服务器,QPS 200万
- 扩容耗时:约 20 分钟
- 缓存命中率:95% → 大幅减少数据库压力
- 降级范围:约 20% 的次要功能被降级
¶ 九、个人点评与学习路径
¶ 9.1 对《可伸缩架构》一书的评价
陈斌的《可伸缩架构》是一本典型的国内一线工程师写的实战书。与译著相比,它的最大优势在于案例接地气——列举了大量国内互联网公司的真实场景,从微博的缓存设计到淘宝的数据库分片策略,都是有据可查的一线经验。
优缺点对比:
| 维度 | 评价 | 说明 |
|---|---|---|
| 实战性 | ⭐⭐⭐⭐⭐ | 大量国内互联网真实案例 |
| 理论深度 | ⭐⭐⭐ | 理论分析相对简略 |
| 实用性 | ⭐⭐⭐⭐⭐ | 拿来就能用 |
| 系统性 | ⭐⭐⭐⭐ | 内容覆盖全面 |
| 新颖度 | ⭐⭐⭐ | 核心技术不变,部分案例略有年代感 |
适合读者:有 2-5 年后端经验的工程师、正在转型架构的开发者、需要设计高并发系统的技术负责人。
阅读建议:不要当作通读书,而应作为"遇到问题时查阅的参考资料"。每次遇到性能瓶颈或伸缩性问题,先翻对应的章节,再结合实际做方案设计。
¶ 9.2 可伸缩架构学习路径
¶ 9.3 延伸阅读
- 《大型网站技术架构:核心原理与案例分析》(李智慧):国内架构经典,与本书互为补充
- 《高可用架构》系列丛书(阿里系):更偏实战,阿里众多产品的经验沉淀
- Designing Data-Intensive Applications(Martin Kleppmann):分布式系统经典
- 《The Art of Scalability》(Martin L. Abbott):系统化的可伸缩方法论
- 《Enterprise Integration Patterns》(Gregor Hohpe):消息集成模式圣经
- Clean Architecture(Robert C. Martin):架构设计思想
¶ 十、总结
可伸缩架构不是某一种具体技术,而是一整套设计思想和实践方法的集合。核心要义可以归纳为:
- 先无状态,再谈扩展 — 无状态是水平扩展的前提
- 分布式 ≠ 可伸缩 — 错误的分片和设计会限制伸缩性
- 缓存是伸缩性的第一利器 — 但需警惕一致性问题
- 异步化是解耦的关键 — MQ 是好东西,但别滥用
- 监控和压测是伸缩性的基石 — 没有数据,无法决策
- 伸缩性是一个持续优化的过程 — 没有"一劳永逸"的架构
关于本书的技术延伸:如果你想深入了解分布式系统的底层理论,推荐《数据密集型应用系统设计》;如果你想窥见万亿级系统的极限设计,可以研究 Google Spanner、Amazon DynamoDB、阿里 PolarDB 的架构论文。可伸缩架构的魅力,正在于它永无止境。
📚 读书笔记 | 架构师书架系列